

Когда крупная технологическая площадка внезапно прекращает работу, последствия редко ограничиваются простым сообщением в новостной ленте. Владимирский дата-центр «Яндекса» — именно такой случай. Компания официально подтвердила полную остановку объекта, сославшись на серьёзные проблемы с инфраструктурой. Часть сервисов уже недоступна, и это лишь верхушка айсберга, под которой скрывается девять лет непрерывного развития вычислительного комплекса.
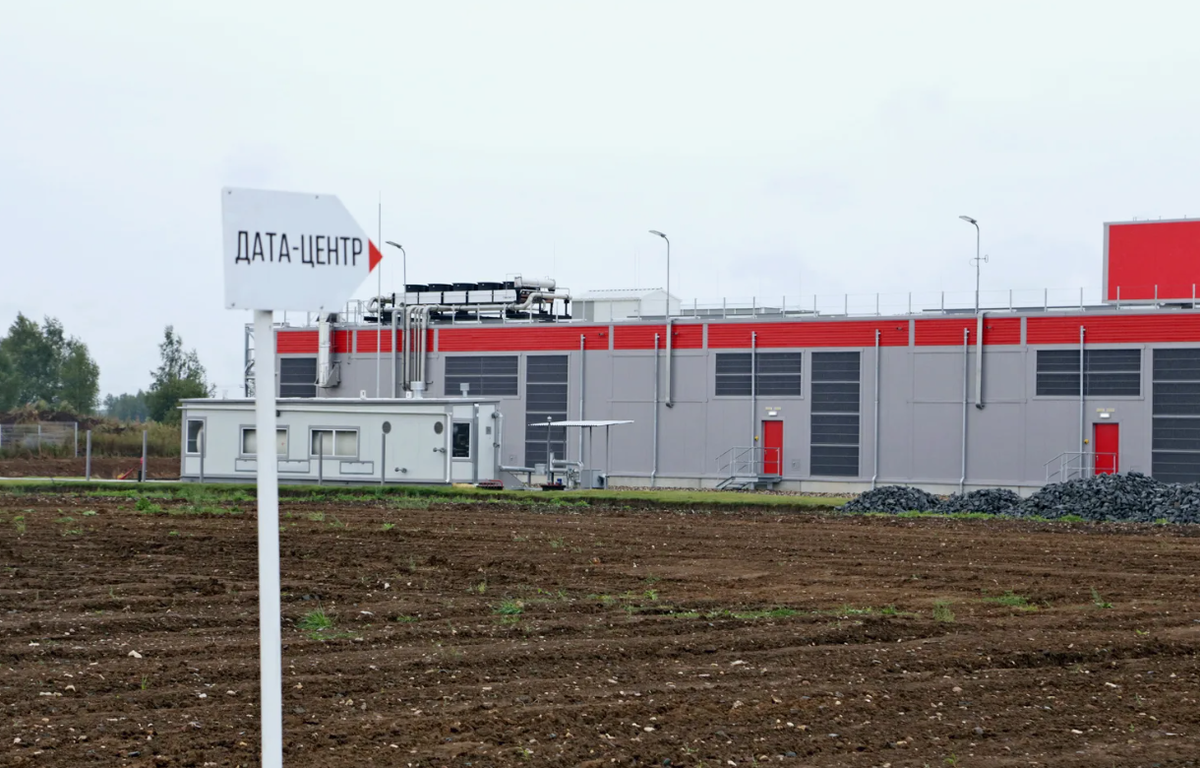
Мне как человеку, который внимательно следит за развитием облачных технологий и вычислительной инфраструктуры в России, сразу стало понятно: речь идёт не о рядовом сбое. Владимирская площадка — это фундаментальный узел, на котором завязаны и пользовательские продукты, и корпоративные клиенты, и исследовательские задачи в области искусственного интеллекта. Потеря такого объекта даже на короткий срок способна вызвать цепную реакцию.
С чего начиналась владимирская площадка
История этого дата-центра началась в 2017 году, когда «Яндекс» впервые запустил здесь собственный вычислительный комплекс, построенный с нуля. Проект изначально предусматривал возможность масштабирования, что для быстрорастущей компании было принципиальным решением. Территория первой очереди заняла внушительные 14,48 гектара, а площадь зданий составила 10 130 квадратных метров.
Проектные характеристики говорили о серьёзных амбициях: комплекс рассчитывался на 2880 серверных стоек и мощность ИТ-оборудования до 40 мегаватт. Правда, сколько именно серверов реально работало перед остановкой, компания никогда не раскрывала. Это стандартная практика для технологических гигантов — не афишировать точные цифры установленного оборудования.
Стойка в дата-центре — это не просто шкаф с железом. Внутри размещаются серверы, сетевое оборудование, системы хранения данных. Однако по количеству стоек невозможно судить о реальной вычислительной мощности: внутри могут стоять как относительно простые машины, так и узлы с десятками ускорителей, каждый из которых стоит как автомобиль премиум-класса.
Расширение инфраструктуры и новая облачная зона
В марте 2026 года компания сделала следующий шаг — ввела в эксплуатацию отдельный дата-центр рядом с прежней площадкой. На его базе заработала облачная зона ru-central1-e. Для нового объекта заявили 40 мегаватт мощности и 2800 стоек. Фактически это означало удвоение вычислительных возможностей владимирского кластера за относительно короткий срок.
Новая площадка проектировалась с учётом требований современного облачного бизнеса. Независимые системы питания и сети, заявленная пропускная способность 25,6 терабит в секунду и задержка между соседними зонами менее одной миллисекунды — всё это критически важно для корпоративных приложений. Базы данных, которые работают в режиме реального времени, не прощают даже малейших сетевых задержек. Владимирский кластер был спроектирован так, чтобы такие задержки были минимальными.
Я не раз сталкивался с тем, как компании недооценивают важность географической близости вычислительных ресурсов. Когда две облачные зоны находятся рядом и обмениваются данными с задержкой меньше миллисекунды, это позволяет строить отказоустойчивые системы, которые продолжают работать даже при выходе из строя одной из площадок. Но если останавливаются обе — резервирование теряет смысл.
Инженерные решения и ставка на энергоэффективность
Владимирский ЦОД с самого начала отличался нестандартным подходом к охлаждению. Вместо традиционных холодильных машин здесь применили схему с наружным воздухом. Через специальные фильтры воздух поступает к серверам, забирает выделяемое ими тепло и выводится обратно на улицу. Зимой часть нагретого воздуха возвращается в зал для поддержания нужной температуры на входе в серверы.
Такая схема позволяет существенно экономить электричество. В традиционных дата-центрах системы охлаждения могут потреблять до трети всей энергии, поступающей на площадку. Здесь же значительную часть года холодильное оборудование просто не требуется. Для компании, которая оперирует тысячами серверов, это миллионы рублей экономии ежегодно.
Однако у такого решения есть и обратная сторона. Зависимость от внешних климатических условий делает систему более уязвимой к аномальной жаре или загрязнению воздуха. Фильтры требуют постоянного обслуживания, а любые сбои в их работе могут привести к перегреву оборудования. Возможно, именно инфраструктурные проблемы, о которых сообщила компания, связаны с этой инженерной особенностью площадки.
Суперкомпьютер «Галушкин» и ставка на искусственный интеллект
Отдельная глава в истории владимирского дата-центра — суперкомпьютер «Галушкин», размещённый здесь в 2021 году. Название выбрано не случайно: Александр Галушкин — известный исследователь теории нейронных сетей, чьи работы заложили основы современных методов машинного обучения. Конфигурация машины впечатляет: 136 вычислительных узлов, 1088 ускорителей NVIDIA A100 с памятью по 80 гигабайт каждый и 136 терабайт оперативной памяти.
Производительность суперкомпьютера в тесте Linpack составила 16,02 петафлопса. Это примерно 16 квадриллионов операций в секунду — число, которое сложно представить, но именно такие мощности нужны для обучения современных языковых моделей, распознавания речи, перевода и поисковых алгоритмов. Каждый раз, когда я пользуюсь голосовым помощником или ищу что-то в интернете, за кулисами работают подобные вычислительные системы.
Судьба «Галушкина» сейчас остаётся неизвестной. Компания не предоставила отдельной информации о состоянии суперкомпьютера после остановки площадки. Но сам факт его размещения во Владимире подчёркивает стратегическое значение этого дата-центра для технологического развития «Яндекса». Потеря таких вычислительных ресурсов — это не только текущие сбои, но и замедление разработки будущих продуктов.
Кто пострадает от остановки
Последствия остановки владимирской площадки выходят далеко за пределы самой компании. Внешний контур — клиенты Yandex Cloud, которые арендуют вычислительные ресурсы, размещают приложения и базы данных. Для многих из них остановка площадки означает простой собственных сервисов, потерю выручки и репутационные риски перед своими клиентами.
Масштаб ущерба для каждого конкретного клиента зависит от того, где именно находились его ресурсы и как было организовано резервирование. Компании, которые грамотно распределили нагрузку между несколькими зонами доступности, могут пережить остановку одной площадки относительно безболезненно. Те же, кто держал всё в одном месте, сейчас столкнулись с полной недоступностью своих систем.
Отдельный вопрос — сроки восстановления. Пока информации о причинах остановки и масштабе повреждений недостаточно, чтобы оценить, сколько времени потребуется на возвращение оборудования в строй. Речь может идти как о днях, так и о неделях или даже месяцах. Для бизнеса, который зависит от непрерывной работы цифровых сервисов, такая неопределённость сама по себе является проблемой.
Что это значит для отрасли
Остановка крупного дата-центра — событие, которое заставляет задуматься о надёжности всей облачной инфраструктуры. Владимирский случай показывает, насколько уязвимыми могут быть даже хорошо спроектированные и масштабные вычислительные комплексы. Когда один объект концентрирует в себе серверные мощности, облачную инфраструктуру и ресурсы для машинного обучения, его простой становится системной проблемой.
Для оценки полных последствий важны три фактора: сроки возвращения оборудования в работу, доступность резервных мощностей и объём расходов на восстановление. Пока ни по одному из этих пунктов нет достоверной информации. Ясно лишь одно: «Яндексу» предстоит серьёзная работа по восстановлению инфраструктуры, а её клиентам — пересмотр стратегий резервирования и аварийного восстановления.
Эта история ещё раз напоминает о том, что цифровая экономика стоит на вполне физических основаниях. Серверы, системы охлаждения, электрические сети — всё это может выйти из строя, и последствия мгновенно ощущаются миллионами пользователей. Возможно, главный урок владимирской остановки в том, что резервирование должно быть не опцией, а обязательным стандартом для любого ответственного облачного бизнеса.